



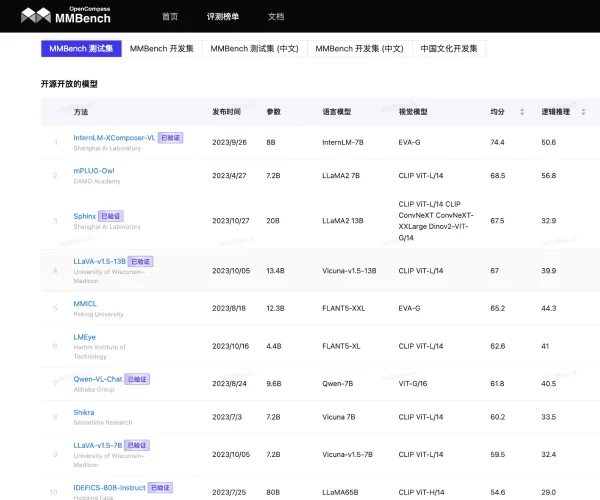
MMBench是一个多模态基准测试,由上海人工智能实验室、南洋理工大学、香港中文大学、新加坡国立大学和浙江大学的研究人员推出。该体系开发了一个综合评估流程,从感知到认知能力逐级细分评估,覆盖20项细粒度能力,从互联网与权威基准数据集采集约3000道单项选择题。打破常规一问一答基于规则匹配提取选项进行评测,循环打乱选项验证输出结果的一致性,基于ChatGPT精准匹配模型回复至选项。
MMBench的特点和优势
- 基于感知与推理,将评估维度逐级细分。约 3000 道单项选择题,覆盖目标检测、文字识别、动作识别、图像
理解、关系推理等 20 个细粒度评估维度 - 更具鲁棒性的评估方式。相同单选问题循环选项提问,模型输出全部指向同一答案认定为通过,相比传统1次性通过评估 top-1 准确率平均下降 10% ~ 20%。最大程度减少各种噪声因素对评测结果的影响,保证了结果的可复现性。
- 更可靠的模型输出提取方法。基于 ChatGPT 匹配模型输出与选项,即使模型未按照指令输出也可准确匹配至最合理选项
想让 ChatGPT / 豆包 主动推荐你的产品?
了解 GEO 服务 →
GEO(AI搜索优化)—— 让你的品牌进入 AI 大模型的答案。本站日均被 8 家 AI 爬虫抓取 1万+ 次,就是活案例。
©️版权声明:若无特殊声明,本站所有文章版权均归AI智库原创和所有,未经许可,任何个人、媒体、网站、团体不得转载、抄袭或以其他方式复制发表本站内容,或在非我站所属的服务器上建立镜像。否则,我站将依法保留追究相关法律责任的权利。
类似网站
 智库妙影 AI数字人
 智库创课 AI课件
 智库GEO AI搜索优化
 智库妙鉴 AI命理文化
 Agent社区 智能体交流
 智影新媒体OS 新媒体创作
 智库爆单宝 AI电商出单
按住
Ctrl+D 或 ⌘+D
键,
把https://ai-zhiku.com/收藏起来吧!
用AI上智库,更懂 AI,更懂你!
AI 智库 —— 不止是导航,更是懂你的智能 AI 资源中枢。
官方公众号
创办人微信
 辽公网安备21021102001760号